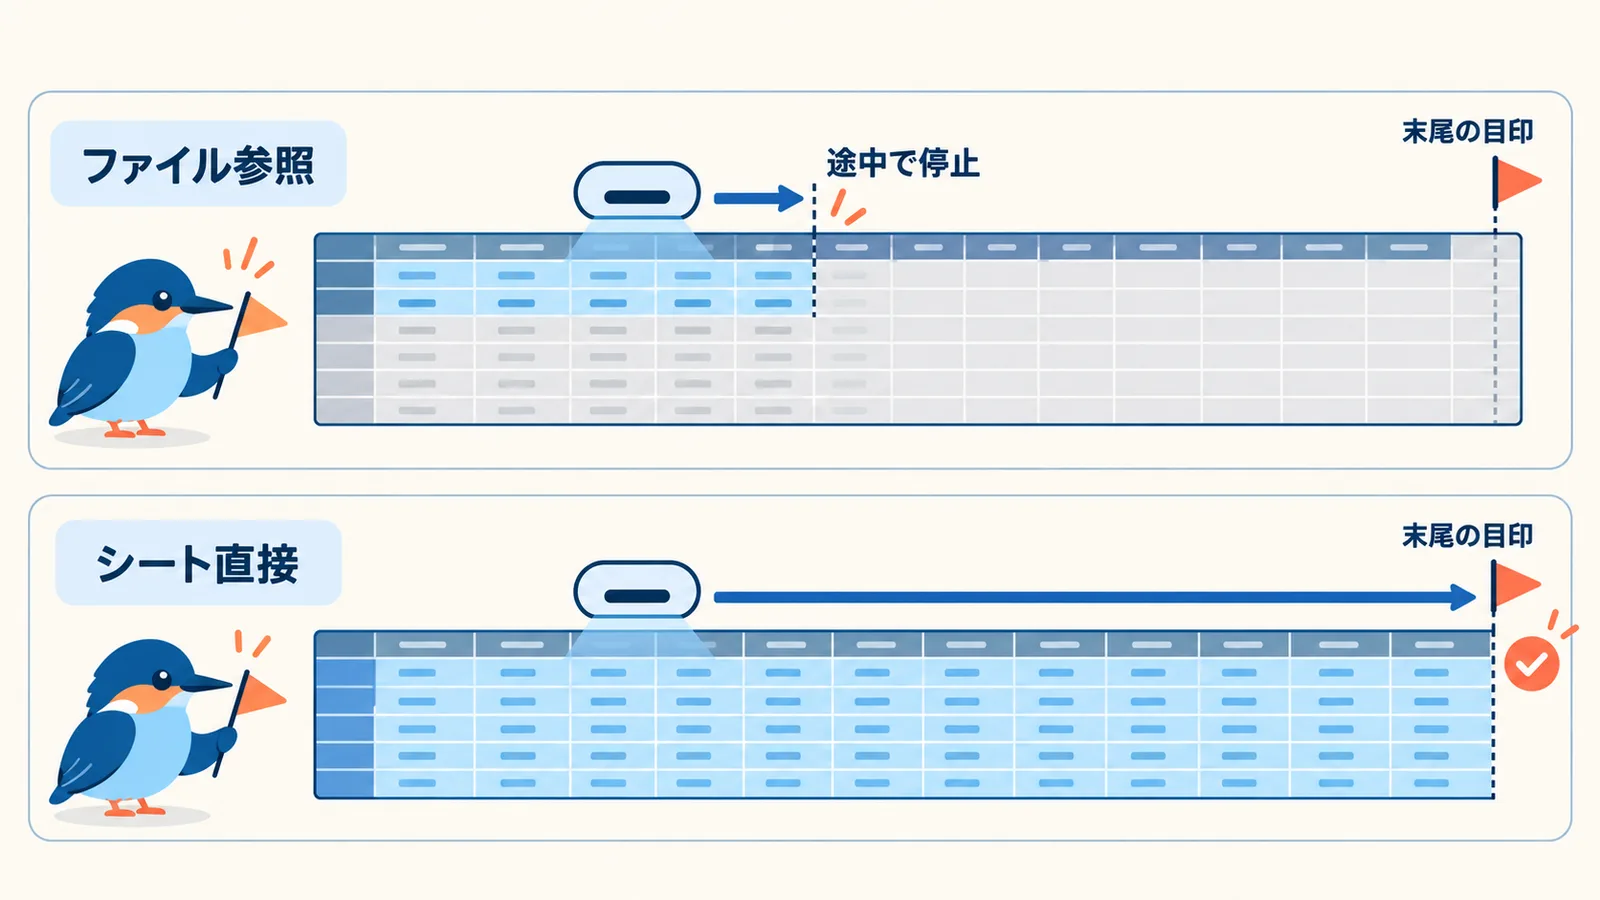
Geminiのファイルの読み取り上限とは、AIが1回の質問で実際に目を通せるデータの範囲のことです。厄介なのは、この上限を超えても、AIが「ここまでしか読めませんでした」とは言わないことです。全件を読んだような口調で、読めた一部だけをもとに答えます。
当社は2026年5月、Google Workspaceの生成AI(Gemini)にCRMのデータを読ませて分析する構成を社内で検証しました。その中で、データ量が増えると回答の元になる範囲が黙って縮むことを、行数と列数ごとに測りました。この記事では、その測り方と結果、あわせて見つかった落とし穴を公開します。製品の上限値として公式に示された数字ではなく、当社の実測であることを先にお断りしておきます。
アップロードできるファイルの数やサイズの上限は、Googleの公式ヘルプ「Gemini アプリでファイルをアップロードして分析する」に示されています(2026年10月7日に当社が確認した時点では、1回の質問に最大10ファイル、動画以外は1ファイル100MBまで)。一方、行数など、中身をどこまで読むかの上限は、このページには書かれていません。この記事で扱うのは、アップロードの上限の内側で起きる、こちらの上限です。
なお、Google WorkspaceのAI活用の全体像はGoogle Workspace×AIの支援ページにまとめています。
なぜ「黙って一部だけ」が問題なのか
CRMのデータをAIに渡して「今月の受注金額の合計は?」「失注理由で多いものは?」と聞く使い方は、すぐにでも試せます。問題は、答えがそれらしく見えることです。
たとえば1,000件の商談データのうち2割しか読めていなければ、合計金額は実際の約2割になります。失注理由の傾向も、読めた2割の中での傾向です。数字の桁が大きく外れていれば気づけますが、傾向や比率は「それらしい」ため、誤りに気づきにくくなります。経営会議の資料にそのまま載ってしまうのが、いちばん避けたい事態です。
どうやって測ったか(末尾マーカー法)
読み取り範囲を測るために、データの各行に目印の列を入れました。1行目は MARKER_ROW000001、1,000行目は MARKER_ROW001000 のように、行番号を含む重ならない文字列です。AIに「最後の行の目印を教えて」と聞き、返ってきた目印の行番号で、どこまで読めたかを判定します。
検証の条件は次のとおりです。
- 検証日:2026年5月21日(当社社内検証)
- データ:架空のCRMデータ(会社名・売上金額・売上日・担当者・カテゴリ・目印の7列)を1,000行/5,000行/1万行/5万行で用意。あわせて、実際のCRMの商談データと同じ項目構成(約70列)を1,000行分の架空データで用意
- 形式:ファイル参照型はCSVファイル。シート直接型は、スプレッドシートとして開いたデータ(当社の構成では、CRMから書き出したExcel形式のファイルをスプレッドシートに変換して使う)
- 比べた方式:
- ファイル参照型:Googleドライブ上のファイルを、Geminiのプロジェクトのソースとして指定し、チャットで質問する方式
- シート直接型:スプレッドシートを開き、Gemini in Sheets(シートの横に出るAIのパネル)で質問する方式
答え合わせのために、各ファイルの行数・合計金額・平均金額・途中の目印を、別途プログラムで計算して控えておきました。
Geminiはファイルを何行まで読めるのか?(結果1:ファイル参照型)
ファイル参照型は、行が増えると急に読めなくなりました。7列のデータでの結果です。
| 行数 | ファイルサイズ | 最後に確認できた目印 | 読めた範囲 |
|---|---|---|---|
| 1,000行 | 約65KB | 1,000行目 | 100% |
| 5,000行 | 約329KB | 2,500行目 | 約50% |
| 1万行 | 約658KB | 1行目 | 実質0% |
| 5万行 | 約3.3MB | 1行目 | 実質0% |
1,000行までは最後まで読めました。5,000行では半分の2,500行目で止まり、1万行を超えると、ほぼ何も読めていない状態でした。それでも回答そのものは返ってきます。
結果2:列が多いと、1,000行でも2割しか読めない
実際のCRMの商談データは、7列では済みません。今回の検証に使った商談データの項目構成は約70列でした。この構成で、1,000行を試しました。
| 条件 | ファイルサイズ | 最後に確認できた目印 | 読めた範囲 |
|---|---|---|---|
| 約70列×1,000行 | 約456KB | 216行目 | 約22% |
7列なら最後まで読めた1,000行が、約70列では216行目で止まりました。行数だけでは説明がつかず、データ量(バイト数)が読める範囲に関わっているように見えます。
ただし、止まった位置のデータ量はそろいませんでした。7列・5,000行で止まった2,500行目までは約165KB、約70列・1,000行で止まった216行目までは約100KBです。当社の2回の測定では、約100〜165KBで止まったことになります。一定のデータ量で決まっているとは言い切れず、上限は列数やファイルの形式でも変わるとみています。仕組みが公式に説明されているわけではなく、2つの条件からの推測です。
スプレッドシートで読み込ませると、結果は変わるのか?(結果3:シート直接型)
シートを直接開けば、同じデータを最後まで読めました。スプレッドシートで開いてGemini in Sheetsに聞いた結果です。
| 条件 | 最後に確認できた目印 | 読めた範囲 |
|---|---|---|
| 5,000行・7列(約329KB) | 5,000行目 | 100% |
| 1,000行・約70列(約456KB) | 1,000行目 | 100% |
ファイル参照型で半分しか読めなかった5,000行も、2割しか読めなかった約70列の1,000行も、最後まで読めました。シートを直接参照する方式のほうが、CRMデータの分析には向いています。当社の検証でも、この結果を受けてシート直接型を標準としました。
ただし、試したのはこの2条件までです。数万行でも最後まで読めるかは確かめていません。
読み取り範囲以外に見つかった4つの落とし穴
1. ファイル名の数字を、件数として答える
ファイル名に「5000」と入っていると、「5,000件です」と答えることがありました。中身の行数を数えた結果ではなく、ファイル名に引きずられた回答です。「何件ありますか」という質問は、読めた範囲の確認にはなりません。
2. 更新前に聞くと、古い値を「更新済み」と答える
当社の構成では、CRMのデータを毎日決まった時刻に書き出して上書きしています。ファイル参照型での検証中、この上書きが終わる前に「今日更新されたデータで」と聞くと、前日の値を「更新済みのデータ」として答えました。AIは、データがいつの時点のものかを確かめていません。当社の推奨は、「更新が終わってから質問する」ことを使う人全員に周知しておくことです。
3. 集計に1〜2%の誤差が出る
当社の検証では、合計や平均に1〜2%程度の誤差が出ました。生成AIは計算機ではないため、大量の足し算で端数がずれます。売上の合計など、そのまま報告に使う数字は、シートの関数や元データで照合が必要です。
4. BigQuery接続のシートでは使えなかった
CRMのデータをBigQuery(Googleのデータ分析用データベース)に同期し、それをスプレッドシートにつなぐ方式(コネクテッドシート)も試しました。2026年5月22日の時点では、この形式のシートでGeminiを開くと「このシート形式はまだサポートされていません」と表示されました。通常のシートにデータを抽出してから使う手順が必要です。
自社で確かめるためのチェックリスト
生成AIにCRMデータを読ませる前に、次の点を確かめてください。
- 最後の行に目印を入れる:ほかと重ならない文字列を最終行に入れ、「最後の行の目印は?」と聞く
- 途中にも目印を入れる:4分の1、半分、4分の3の位置にも入れておくと、どこで止まったかが分かる
- 件数の質問で確かめた気にならない:ファイル名や見出しの数字をそのまま答えることがある
- 合計値を一つ控えておく:関数で出した合計とAIの答えを比べ、ずれの大きさを把握する
- 列を絞る:分析に要らない列を外すと、同じ方式でも読める行が増える
- 行を絞る:期間やステータスで対象を絞り、1回に渡す量を減らす
- 更新のタイミングを決める:データの書き出しが終わってから質問する運用にする
- 方式を選ぶ:ファイル参照型は、少量の資料をまとめて読ませる用途にとどめ、CRMデータの分析はシート直接型を基本にする
データ量別の使い分け(当社の目安)
検証結果をもとに、当社では次の目安で方式を選んでいます。いずれも2026年5月時点の実測にもとづく目安で、製品の保証値ではありません。
| データの量 | 向いている方式 | 注意点 |
|---|---|---|
| 数百行・列が少ない | ファイル参照型でも可 | 末尾マーカーで最後まで読めたかを確かめる |
| 1,000〜5,000行程度 | シート直接型(Gemini in Sheets) | 合計などの数字は関数で照合する |
| 数万行以上 | 行を絞ってシート直接型で聞く/分析用の置き場に同期し、集計結果をAIに渡す構成も選択肢 | 数万行を最後まで読めるかは未検証。同期の時刻と、質問してよい時刻を決めておく |
データが多いなら「一度ためてから聞く」
CRMの件数が数万件ある場合、ファイルで渡す方式は実用になりませんでした。シートに全件を載せる方式も、数万行で最後まで読めるかは確かめていません。当社の検証では、シート直接型を標準としました。数万行になる場合の選択肢として、CRMのデータを分析用の置き場(BigQueryなど)に毎日同期し、AIには集計済みの結果や絞り込んだ範囲を渡す構成も検証しています(数万行で最後まで読めるかは未検証です)。
会議や電話、メールの記録をCRMにためていく仕組みについてはクローズドループ基盤の作り方で解説しています。
この「一度ためる」考え方は、当社独自のやり方ではありません。CRMのAPI(システム同士でデータをやり取りする窓口)は、1件ずつの登録や更新を前提に作られており、一度に取れる件数や回数に上限があります。そのため一般に、大量のデータを分析するときは、取引用のCRMとは別に分析用の置き場を用意する構成がよく取られます。AIを使うかどうかに関係のない考え方です。
この検証から分かったこと
生成AIにCRMデータを読ませること自体は、すぐに試せます。難しいのは、答えが正しい範囲のデータから出ているかを確かめることです。今回の検証では、条件によっては全体の2割しか読まれていないのに、回答は普通に返ってきました。
AIに数字を聞く前に、「どこまで読めたか」を測る仕組みを一つ入れておく。それだけで、会議資料に誤った数字が載る事故はかなり防げます。CRMデータとAIをどうつなぐか、どこまでAIに任せるかを設計したい場合は、Google Workspace×AIの支援ページからご相談ください。営業データの整え方そのものは営業DXの全体像で解説しています。
よくある質問
Geminiのファイル上限は、公式には何行ですか?
公式ヘルプに示されているのは、アップロードできるファイルの数やサイズの上限で、行数の上限は書かれていません(2026年10月7日確認)。この記事の数字は公式に示された上限ではなく、2026年5月時点に当社が特定の条件(ファイル参照型はCSVの7列または約70列)で測った実測値です。当社の2回の測定では、ファイル参照型はデータ量でおよそ100〜165KBのところで読み取りが止まりました。上限は列数や形式、製品の更新で変わるとみられるため、自社のデータで同じ方法(末尾マーカー)を使って確かめることをお勧めします。
AIが全部読めたかどうかは、どうすれば確かめられますか?
データの最後の行に、ほかと重ならない目印の文字列を入れておき、「最後の行の目印は何ですか」とAIに聞きます。正しく答えられれば最後まで読めています。途中の目印しか返ってこなければ、そこで読み取りが止まっています。件数を聞くだけでは確かめになりません。ファイル名や見出しの数字を、そのまま件数として答えることがあるためです。
CRMのデータが数万件あります。AIで分析するにはどうすればいいですか?
当社の検証では、数万行をファイルのまま読ませる方式は実用になりませんでした。まずは期間やステータスで行を絞り、スプレッドシートで直接聞く方法があります。もう一つの選択肢が、分析用の置き場(たとえばBigQueryのようなデータベース)にいったん同期し、AIには集計済みの結果や必要な範囲だけを渡す構成です。当社もこの構成を検証していますが、数万行を最後まで読めるかまでは確かめていません。
Gemini in Sheetsなら、どんな量でも正確に分析できますか?
そうとは言えません。当社の検証で最後まで読めたのは、5,000行・7列と、1,000行・約70列の2条件です。それ以上の量は試していません。また、読めていても足し算などの集計に1〜2%の誤差が出ました。重要な数字は、スプレッドシートの関数や元データで必ず照合してください。
BigQueryにつないだシート(コネクテッドシート)でGeminiは使えますか?
2026年5月22日の当社検証では、BigQueryに接続したシートでGeminiを開くと「このシート形式はまだサポートされていません」と表示され、使えませんでした。データを通常のシートに抽出してからGeminiを使う手順で運用しています。仕様は変わる可能性があるため、導入時点で確かめてください。
この記事の著者: 宮村 佳祐(株式会社etika 代表取締役)BtoBメディアとMAツール「リストファインダー」の立ち上げ・事業拡大を経て、ニッチな強みを持つBtoB中小企業の売れる仕組みづくりを支援。プロフィール詳細 →