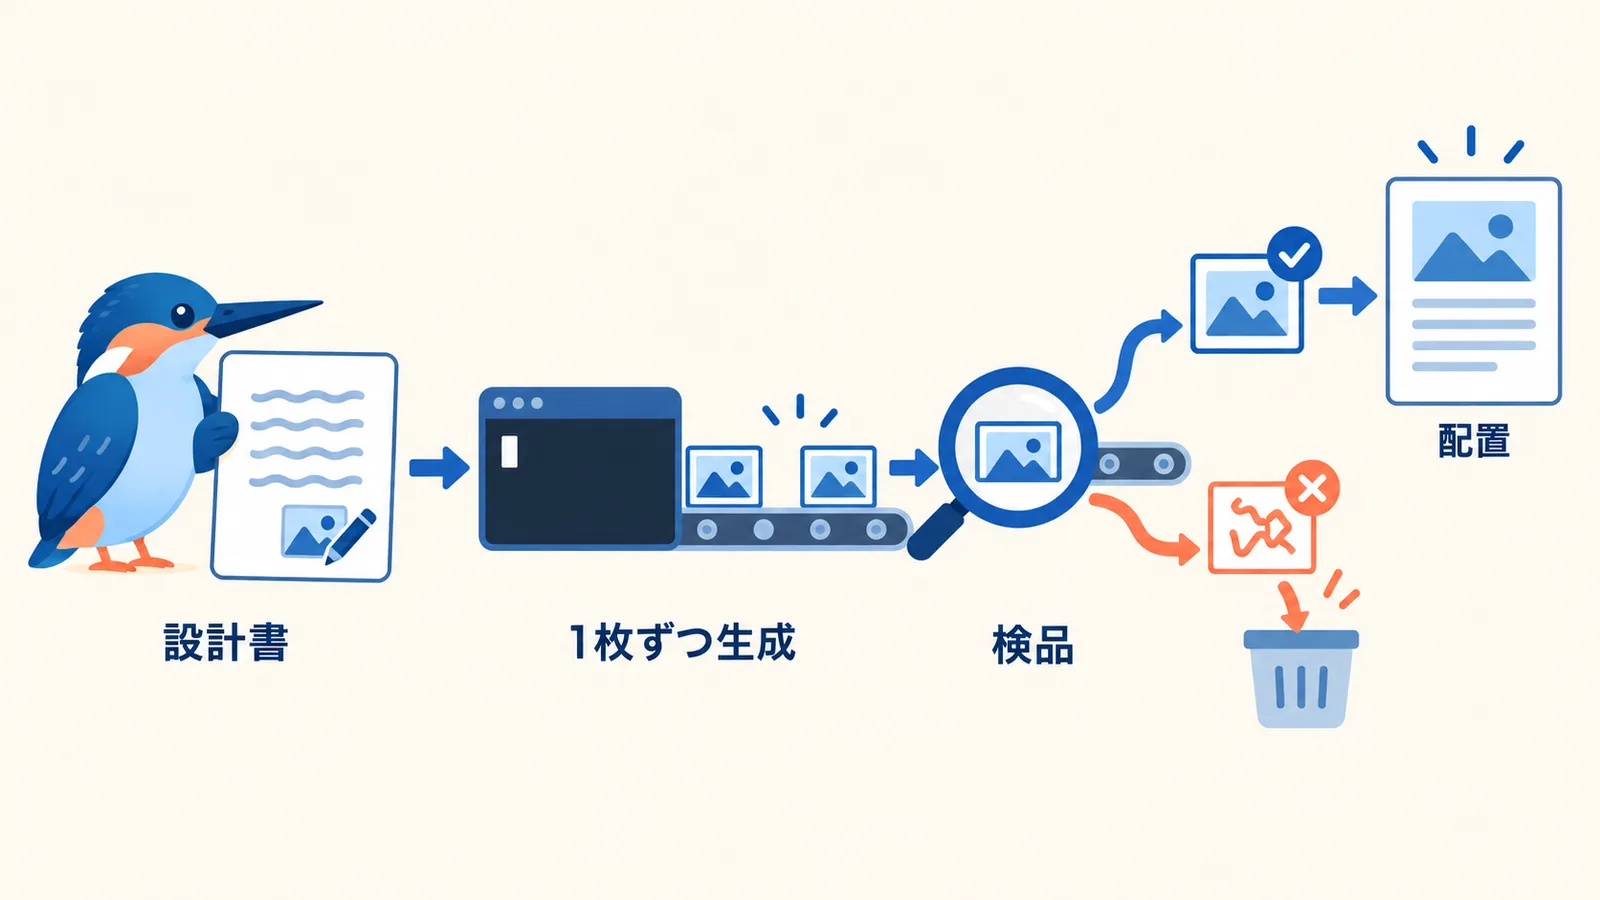
Codexの画像生成とは、OpenAIのコーディングエージェント「Codex」のCLIを非対話で動かし、内蔵の画像生成ツールで画像を作ってPNGとして保存させる使い方です。当社(株式会社etika)の環境では、画像のモデルはgpt-image-2を使っています。
当社は2026年10月8日、自社の2つのサイトの記事47本に、挿絵を合わせて81枚入れました。デザイナーに頼むほどではないけれど、文字だけの記事では伝わりにくい。そんな場面で、図解をAIで作る手順と、使える画像を見分ける基準をまとめます。
当社で作ったもの:47本の記事に81枚
内訳は次のとおりです。
| サイト | 種類 | 枚数 | 画像内の文字 |
|---|---|---|---|
| etika.life | 記事冒頭のメインビジュアル | 13枚 | 短い日本語ラベル2〜5個 |
| CRMサポートセンター | 一覧と記事冒頭のカバー | 34枚 | 文字なし(タイトルはあとから合成) |
| CRMサポートセンター | 本文の図 | 34枚 | 短い日本語ラベル2〜5個 |
生成は5並列で、81枚すべてが1回目で保存でき、失敗は0枚でした。検品のあとの作り直しも0枚です。81枚の生成の実行は、ファイルの作成時刻で見ると約20分でした。企画ルールづくりから検品、両サイトへの配置まで含めても、ファイルの時刻で約35分でした。
先に「企画ルール」を1枚決める
いきなりプロンプトを書くと、1枚ごとに絵柄も考え方もばらつきます。当社は最初に、企画ルールを1枚のメモにまとめました。中身は4つです。
- サイトごとの作るもの(種類・置き場所・比率・文字の量)
- 図の考え方:装飾でなく、記事の主張・構造・判断の順序を1枚1メッセージで見せる(対比・流れ・分岐・チェック・層)
- 描かないもの:実在の製品のロゴや画面、社名、顧客データ。人物は単純なピクトグラムまで。握手の会議写真・人型ロボット・光る脳・サイバー風は使わない
- スタイル句:サイトごとの絵柄を英語で固定し、すべてのプロンプトの末尾にそのまま付ける
いちばん効くのは4のスタイル句です。etika.lifeでは「クリーム地、紺と青と薄い青、差し色はコーラルオレンジ、左側にカワセミのマスコット」といった指定を毎回同じ文で付けています。81枚の絵柄をそろえるうえで最も効いたのは、この一文を変えなかったことだと当社は見ています。
図解をAIで作るプロンプトは、どう書く?
記事ごとの設計書(当社ではVisual Briefと呼んでいます)は、次の形にしました。
- 記事のslug・サイト・種類(メイン/カバー/本文の図)
- 代替テキスト(何を表す図か、60〜100字)
- キャプション(読者向けに1〜2文)
- ファイル名
- 英語のプロンプト本文+スタイル句
本文は英語で、図の構成を具体的に書きます。画像に入れる日本語だけを「」で囲みます。たとえば、GA4の計測の穴を扱った記事のメインビジュアルは、次のように書きました(一部省略)。
Flat vector diagram of a measurement check. In the center, a large rounded
dashboard panel showing a simple daily bar chart where a run of bars suddenly
drops to an empty flat gap, marked with a small coral orange warning dot;
Japanese label 「計測停止」 under the gap. On the right, a web page pictogram
containing an embedded form box; a dotted arrow from the form toward the
dashboard breaks off halfway, Japanese label 「送信漏れ」 near the broken arrow.
...
Style: flat vector illustration for a Japanese B2B consulting website, ...
no logos, no real product UI, no other readable text, high clarity.
Aspect ratio: 16:9.
書くときのコツは3つです。
- 位置を言葉で決める:「中央に」「右に」「左下に」と置き場所を指定する
- ラベルは短く少なく:1ラベル2〜6字、1枚に2〜5個まで
- 描かないものを最後に書く:「指定以外の文字は描かない」「ロゴや実在の画面は描かない」
codex execへの渡し方:翻訳・改変させない
生成は、設計書からプロンプトを1枚ずつテキストファイルに切り出し、Pythonのスクリプトから codex exec を呼んで行いました。Codexへの指示は、毎回この定型文です。
あなたの画像生成ツール(image2 / GPT Image)で画像を1枚だけ生成してください。
次のプロンプトを厳密に使用(翻訳・改変・追記をしない):
---
{プロンプト}
---
生成完了後、出力されたPNGを次の絶対パスへ必ずコピー: {保存先}
最後に保存先の絶対パスと解像度(px)だけを1行で出力してください。
「翻訳・改変・追記をしない」を入れているのは、Codexが気を利かせてプロンプトを書き足すのを防ぐためです。設計書で決めたラベルや配置が勝手に変わると、検品の基準が崩れます。
呼び出しは次の形です。書き込みを出力フォルダだけに絞るサンドボックスで動かしています。
codex exec --sandbox workspace-write --skip-git-repo-check \
  -c 'approval_policy="never"' -C ./out "(上の定型文)"
当社が実際につまずいたのは approval_policy です。これを付けないと、Codexが操作の承認を待ったまま止まります。非対話で動かすときの設定は、OpenAIの公式ドキュメント(Non-interactive mode|Codex)にまとまっています。
スクリプト側では、次の3つを入れました。
- 並列数を指定できるようにする(今回は5)
- 1枚ごとに時間の上限(15分)と再試行(2回)を付け、保存できたかはファイルの有無で判定する
- 既にある画像は飛ばす(失敗した分だけ流し直せる)
Codexの画像生成に制限や癖はある?
当社が確認した時点(2026年10月、codex-cli 0.160.1)で分かっていることです。
- 画像のモデルはgpt-image-2まで。より新しいモデルを指定する設定は見当たらなかった
- 16:9を指定すると、1672×941ピクセル前後のPNGが返る。今回の81枚では1枚だけ縦が1ピクセル少なかった
- 平面的なイラストは、背景が透明(透過PNG)で返ることがある。当社の別の生成では、透過PNGで返ったことがある
透過のまま記事に置くと、サイトの背景色が透けて別の絵に見えます。そこで配置のスクリプトで、透過していれば白で塗りつぶしてから、1600×900のWebPに変換しています。サイズのばらつきも、この変換でそろいます。
検品の基準:使えなかった画像の見分け方
81枚は2枚ずつ並べた一覧画像にして、まとめて目で見ました。見たのは次の点です。
- 日本語ラベルの誤字や、存在しない文字(それらしいけれど読めない字)
- 指定していない文字や数字が描かれていないか
- 人物の描き方:ピクトグラムと指定しても、表情や髪型まで描き込まれた人物で返ってくることがあった
- カバーの余白:左下を空けるよう指定しても、図が下まで伸びてくる画像があった
- 右上のサイト名とのぶつかり:合成するサイト名の位置に図が来ていないか
- 1枚1メッセージになっているか:記事の主張と図の主張がずれていないか
今回は、1と2で作り直しが要る画像はありませんでした。3は、記事の内容とずれない範囲だったため、そのまま使いました。4は、カバーにタイトルを合成するスクリプトで、画像の下側に白のグラデーションを重ねて読みやすさを確保しています。図が多少はみ出しても、タイトルが読めれば使える、という判断です。
1枚ずつ開くより、一覧で並べて見るほうが、絵柄のばらつきや余白の取り方の違いに気づきやすくなります。
配置まで自動にすると、何度でも流し直せる
検品が済んだ画像は、配置のスクリプトで両サイトに置きました。
- etika.life:WebPに変換し、記事とひも付ける一覧に代替テキストとキャプションごと登録
- CRMサポートセンターのカバー:タイトルとサブタイトルを合成してJPEGにし、記事の設定に画像の場所と代替テキストを追記
- CRMサポートセンターの本文の図:WebPに変換し、設計書で指定した見出しの直後に挿入
スクリプトは何度流しても同じ結果になるように作りました。既に登録済みなら追記しない、見出しが見つからなければ止めて知らせる、という作りです。1枚だけ作り直したときも、同じコマンドで差し替えられます。
記事を量産するときは、挿絵の前に「その記事がそもそも検索エンジンに認識されているか」も確かめておくと安心です。当社が公開翌日の点検で見落としに気づいた話は、AIで量産した記事がインデックスされないにまとめています。実際の挿絵は、GA4のキーイベントは正しく数えられているかなどの記事冒頭で見られます。
挿絵に限らず、記事・広告・メール・CRMの作業をClaude Codeで回した記録は、Claude Codeでマーケ運用を回すで公開しています。
ブログの挿絵をAIで作るときのチェックリスト
- サイトごとの比率・文字の量・描かないものを企画ルールに書いた
- 絵柄を決めるスタイル句を英語で固定し、全プロンプトの末尾に付けた
- 1枚1メッセージで、記事の主張・構造・判断の順序を図にしている
- 日本語ラベルは短く少なく、「」で囲んで指定した
- Codexには「翻訳・改変・追記をしない」と指示している
- 非対話で動かすときの承認の設定を付けた
- 保存できたかをファイルの有無で判定し、失敗分だけ流し直せる
- 透過と画像サイズを、配置の前にそろえている
- 一覧にして、誤字・指定外の文字・人物・余白を目で確かめた
挿絵は、記事の主張を一目で伝えるための部品です。AIに任せるのは描く作業で、何を描くか・使えるかの判断は人が持つ。この線を引いておけば、数十枚単位でも絵柄と品質をそろえられます。記事づくりを含むWeb集客全体の進め方は、AI SEOとはで解説しています。Codexなどを自社で運用して記事や挿絵の制作を回したい場合は、マーケ担当AIエージェント(直接運用型)で支援の内容を紹介しています。
よくある質問
Codexの画像生成には制限はありますか?
当社が確認した時点(2026年10月、codex-cli 0.160.1)では、画像のモデルはgpt-image-2までで、画像モデルを選ぶ設定もありませんでした。16:9を指定すると1672×941ピクセル前後のPNGが返ります。利用回数の上限は契約しているプランによって変わるため、OpenAIの案内で確かめてください。
日本語の文字はきれいに出ますか?
短いラベルなら、当社の81枚では作り直しが要るほどの誤字はありませんでした。1ラベル2〜6字程度、1枚に2〜5個までに絞り、プロンプトの中で「」で囲んで指定しています。長い文章やタイトルは画像に描かせず、あとから合成しています。
1枚あたりの費用や時間はどのくらいですか?
費用は測っていません。時間は、81枚を5並列で生成した実行が約20分でした(ファイルの作成時刻から算出)。企画ルールづくりから検品、配置、本番への反映まで含めても、ファイルの時刻で約35分でした。
挿絵に人物や実在の製品画面を入れてもいいですか?
当社は入れない方針にしています。製品のロゴや画面、社名を描かせると、権利や誤解のもとになるためです。人物は単純なピクトグラムにとどめ、握手の写真風や人型ロボット、光る脳のような定番のイメージも使いません。
ChatGPTの画面で作るのと何が違いますか?
画質の差より、量と再現性の差です。CLIから動かすと、設計書のプロンプトを1文字も変えずに渡せ、数十枚を並列で作り、失敗したものだけを再実行できます。1〜2枚ならChatGPTの画面で十分です。
この記事の著者: 宮村 佳祐(株式会社etika 代表取締役)BtoBメディアとMAツール「リストファインダー」の立ち上げ・事業拡大を経て、ニッチな強みを持つBtoB中小企業の売れる仕組みづくりを支援。プロフィール詳細 →